Benchmark contamination là gì? Vì sao Google DeepMind phải đánh giá AI theo kiểu double-blind?
Benchmark contamination là gì? Tìm hiểu vì sao dữ liệu benchmark lọt vào training có thể làm sai lệch điểm AI và cách Google DeepMind thử double-blind evaluation để bảo vệ tính toàn vẹn của phép đánh giá.

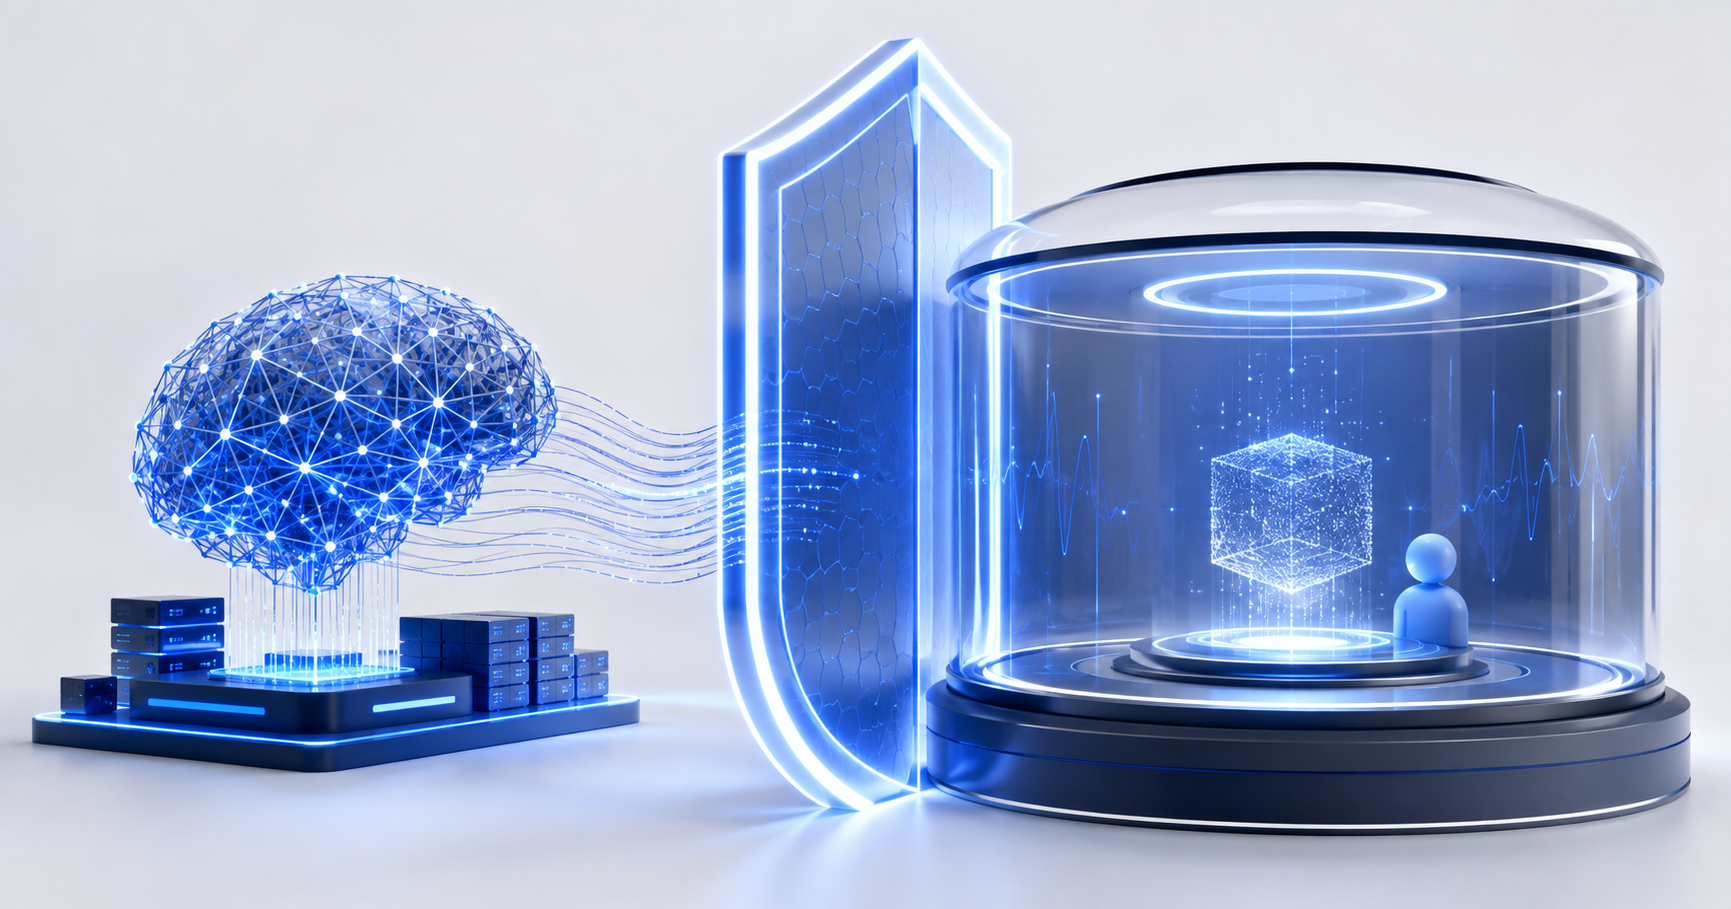
Benchmark contamination xảy ra khi một mô hình AI đã nhìn thấy một phần hoặc toàn bộ dữ liệu dùng để đánh giá trước khi bài kiểm tra chính thức diễn ra. Khi đó, điểm benchmark có thể phản ánh mức độ quen thuộc với “đề thi” thay vì năng lực thật của mô hình.
Ngày 27/8/2026, Google DeepMind công bố một pilot mà hãng gọi là double-blind AI evaluation đầu tiên dành cho một mô hình frontier độc quyền. Thay vì để nhà phát triển nhìn thấy prompt đánh giá hoặc buộc evaluator nhận model weights, hai bên đưa tài sản bí mật vào một môi trường tính toán được bảo vệ bằng mật mã. Mục tiêu là làm cho kết quả đánh giá đáng tin hơn mà không buộc bên nào phải từ bỏ bí mật của mình.
Tóm tắt nhanh
• Benchmark contamination là hiện tượng dữ liệu hoặc prompt đánh giá lọt vào quá trình huấn luyện, tinh chỉnh hoặc tối ưu mô hình trước khi kiểm tra chính thức.
• Hệ quả lớn nhất là điểm benchmark có thể bị thổi phồng, khiến người dùng khó biết mô hình thực sự giỏi hay chỉ đã “biết đề”.
• Google DeepMind đã thử nghiệm double-blind evaluation với Gemini 2.5 Flash-Lite, OpenMined, AVERI, MLCommons và Singapore AI Safety Institute.
• Pilot dùng secure GPU enclave để Google không thấy prompt bí mật, còn evaluator không thấy model weights độc quyền.
• Double-blind evaluation giúp giảm rủi ro contamination nhưng không tự động giải quyết mọi vấn đề của benchmark; thiết kế bài test, quản trị dữ liệu và quy trình audit vẫn rất quan trọng.
Benchmark contamination là gì?
Benchmark contamination có thể hiểu đơn giản là tình trạng “đề thi bị lộ” đối với mô hình AI. Một benchmark được tạo ra để kiểm tra khả năng của model trên dữ liệu mà nó chưa từng thấy. Nếu prompt, đáp án hoặc các biến thể rất gần của bộ test đã xuất hiện trong dữ liệu huấn luyện, fine-tuning hoặc một vòng tối ưu trước đó, tính độc lập của phép đo bị suy giảm.
Ví dụ, giả sử một benchmark có 1.000 câu hỏi để đo khả năng suy luận. Nếu một phần đáng kể các câu hỏi đó đã nằm trong dữ liệu training, model có thể trả lời đúng nhờ ghi nhớ mẫu hoặc nhận ra cấu trúc quen thuộc. Điểm số vẫn cao, nhưng nó không còn đại diện chính xác cho khả năng xử lý những câu hỏi mới.
Vấn đề này đặc biệt khó trong thời đại mô hình nền tảng vì dữ liệu training có quy mô rất lớn và được tổng hợp từ nhiều nguồn. Một benchmark công khai, một repository trên GitHub, một bài blog phân tích benchmark hoặc thậm chí các prompt từng gửi qua một hệ thống đánh giá đều có thể trở thành đường dẫn khiến dữ liệu test bị lộ vào chu trình phát triển model.
Benchmark contamination khác gì data contamination?
Hai khái niệm có liên quan nhưng không hoàn toàn giống nhau. Data contamination là khái niệm rộng hơn, chỉ việc dữ liệu không mong muốn hoặc dữ liệu cần được tách biệt lọt vào tập huấn luyện hay tập đánh giá. Benchmark contamination tập trung cụ thể vào việc dữ liệu dùng để đo hiệu năng của model đã bị model hoặc quy trình tối ưu “nhìn thấy” trước khi đánh giá.
Một benchmark có thể bị contamination trực tiếp khi prompt test xuất hiện trong training data, hoặc gián tiếp khi nhà phát triển liên tục tối ưu model dựa trên những tín hiệu quá sát với bộ test bí mật. Vì vậy, chỉ giữ một file benchmark ở chế độ private chưa chắc đã đủ để bảo vệ tính toàn vẹn của phép đánh giá.
Vì sao benchmark contamination là vấn đề nghiêm trọng?
Điểm số có thể cao hơn năng lực thực
Benchmark chỉ có giá trị khi nó đo được khả năng tổng quát hóa trên tình huống mới. Nếu model đã thấy đề, một phần điểm số có thể đến từ ghi nhớ hoặc tối ưu đặc thù thay vì năng lực thực. Điều này khiến việc so sánh model A với model B trở nên thiếu công bằng.
Nhà phát triển có thể vô tình tối ưu theo benchmark
Ngay cả khi không cố tình “học thuộc đề”, một đội phát triển có thể điều chỉnh model nhiều lần dựa trên kết quả của cùng một benchmark. Qua đủ số vòng, benchmark dần trở thành mục tiêu tối ưu thay vì công cụ đo lường độc lập. Hiện tượng này tương tự việc học sinh luyện đúng một bộ đề đến mức điểm cao nhưng chưa chắc hiểu sâu môn học.
External evaluation mất đi tính độc lập
Với các đánh giá an toàn do tổ chức bên ngoài thực hiện, prompt thường chính là tài sản quan trọng nhất của evaluator. Nếu toàn bộ bộ câu hỏi phải được gửi cho nhà phát triển model để chạy test, evaluator phải tin rằng prompt sẽ không bị lưu, phân tích hoặc dùng để tối ưu các phiên bản model tương lai. Hợp đồng và quy tắc zero-logging giúp giảm rủi ro, nhưng không tạo ra cùng mức bảo đảm như một cơ chế kỹ thuật có thể kiểm chứng.
Double-blind AI evaluation là gì?
Trong pilot của Google DeepMind, “double-blind” không có nghĩa hoàn toàn giống thử nghiệm mù đôi trong y học. Ở đây, khái niệm này mô tả một cơ chế mutual confidentiality: evaluator không được nhìn thấy model weights độc quyền, còn nhà phát triển model không được nhìn thấy prompt đánh giá bí mật.
Trước đây, một bài kiểm tra độc lập thường phải chấp nhận một trong hai đánh đổi. Hoặc nhà phát triển gửi model cho evaluator và chịu rủi ro lộ sở hữu trí tuệ; hoặc evaluator gửi prompt cho nhà phát triển và chịu rủi ro lộ “đề thi”. Double-blind evaluation cố gắng loại bỏ lựa chọn khó này bằng cách đưa cả hai tài sản vào một môi trường tính toán được cách ly.
Google DeepMind đã thử nghiệm double-blind evaluation như thế nào?
Google DeepMind cho biết pilot sử dụng Confidential Space trong hệ sinh thái Confidential Computing của Google Cloud. OpenMined cung cấp phần mềm PySyft để điều phối việc gửi, phê duyệt và thực thi code cùng các tài sản bí mật trong GPU enclave.
Bước 1: Nhà phát triển giữ bí mật model weights
Google DeepMind đưa một phiên bản proprietary của Gemini 2.5 Flash-Lite vào môi trường được bảo vệ. Model weights không được gửi trực tiếp cho AVERI, OpenMined, MLCommons hay Singapore AISI.
Bước 2: Evaluator giữ bí mật prompt đánh giá
Ở pilot do AVERI thực hiện, MLCommons cung cấp một tập prompt chưa từng được sử dụng trước đó từ họ benchmark an toàn AILuminate. AVERI mã hóa prompt trước khi đưa chúng vào môi trường đánh giá. Một pilot khác với Singapore AI Safety Institute cũng sử dụng prompt chưa phát hành của tổ chức này.
Bước 3: Hai bên xác minh môi trường thực thi
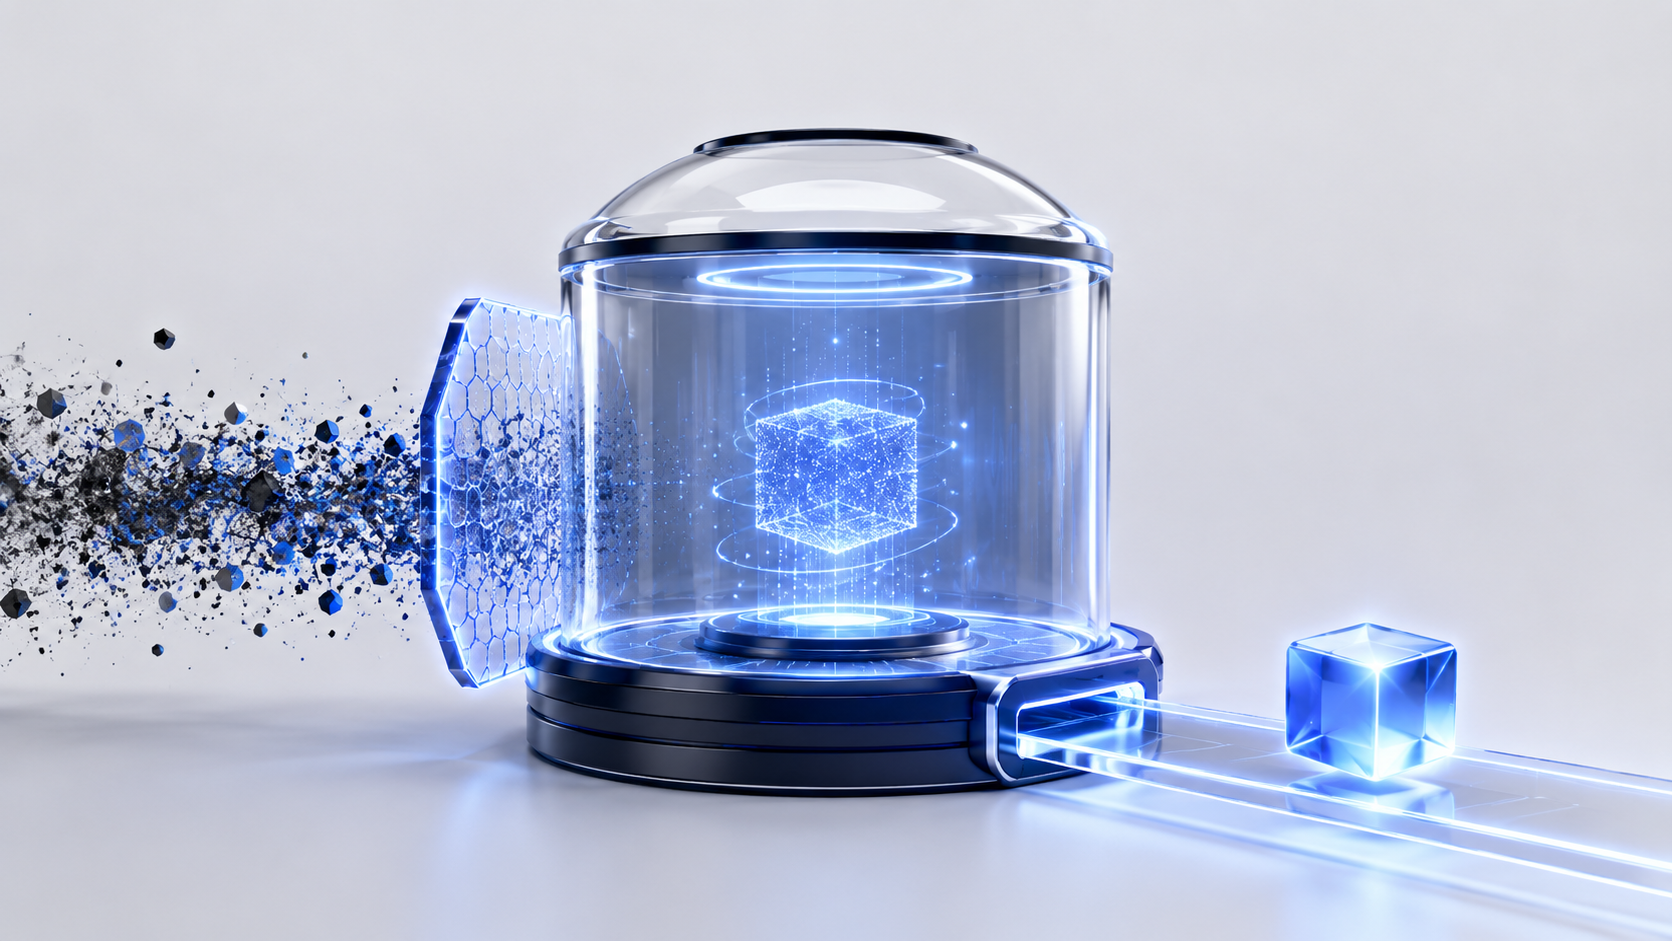
Secure enclave hoạt động như một vùng tính toán cô lập. Trước khi dữ liệu bí mật được đưa vào, các bên có thể xác minh code nào sẽ chạy và những output nào được phép rời khỏi enclave. Mục tiêu là giảm nhu cầu phải tin tưởng một bên bằng lời hứa đơn thuần.
Bước 4: Model và benchmark gặp nhau bên trong enclave
Prompt được chạy trên Gemini 2.5 Flash-Lite bên trong môi trường cách ly. Google DeepMind không nhận được prompt để lưu hoặc huấn luyện lại model trên chúng, trong khi evaluator không có quyền truy cập trực tiếp vào model weights.
Bước 5: Chỉ output đã thỏa thuận được đưa ra ngoài
Trong pilot AVERI, AVERI giải mã output và chấm chúng theo tiêu chí của AILuminate. Báo cáo kết quả được gửi riêng cho Google DeepMind; các prompt và output cụ thể vẫn được giữ bí mật để bảo vệ benchmark.
Secure enclave là gì và vì sao nó quan trọng?
Secure enclave hay trusted execution environment là một vùng thực thi được cô lập bằng phần cứng và cơ chế bảo mật. Code và dữ liệu bên trong được thiết kế để không thể bị đọc tùy ý bởi hệ điều hành, người vận hành hạ tầng hoặc các bên không được cấp quyền.
Điểm quan trọng với AI evaluation là khả năng attestation: các bên có thể xác minh môi trường đang chạy đúng code đã thống nhất trước khi đưa model hoặc benchmark bí mật vào. Nhờ đó, evaluator có thể kiểm tra một model độc quyền mà không cần nhận bản sao model, còn model provider có thể cho phép đánh giá mà không cần nhận bộ prompt test.
Tuy vậy, secure enclave không phải một “hộp ma thuật” bảo đảm mọi thứ đều an toàn. Thiết kế code chạy trong enclave, cấu hình output, chuỗi cung ứng phần cứng, cách quản lý khóa và quy trình phê duyệt vẫn phải được audit cẩn thận.
Pilot đã dùng benchmark nào?
MLCommons cung cấp prompt từ AILuminate, một họ benchmark tập trung vào AI risk và reliability. AILuminate sử dụng cả prompt công khai cho practice và prompt private cho Official Test để giảm nguy cơ hệ thống bị tối ưu quá mức theo bộ đề chính thức.
Theo AVERI, tập prompt bí mật dùng trong pilot bao phủ các nhóm nguy cơ như CBRNE, cyberattacks, hate speech, self-harm và violent crime elicitation. AILuminate nói rộng hơn về 12 nhóm hazard trong benchmark safety cho mô hình chat đa dụng.
Kết quả chi tiết của pilot không được công bố công khai. AVERI cho biết họ gửi cho Google DeepMind một báo cáo bí mật về các điểm thành công, failure mode và một số kết quả định lượng. Việc giữ prompt và output riêng tư là một phần của thiết kế, vì nếu công bố toàn bộ dữ liệu test thì benchmark lại có nguy cơ bị contamination trong các model tương lai.
Double-blind evaluation khác benchmark AI thông thường thế nào?
Benchmark công khai: thuận lợi cho nghiên cứu, tái lập kết quả và so sánh rộng rãi, nhưng prompt có thể nhanh chóng xuất hiện trên web và trong training corpus.
Benchmark bí mật truyền thống: giữ prompt private nhưng thường yêu cầu evaluator gửi prompt qua API hoặc trực tiếp cho nhà phát triển, tạo ra câu hỏi về logging, lưu trữ và khả năng prompt ảnh hưởng tới các vòng phát triển sau.
Double-blind evaluation: cố gắng giữ đồng thời hai phía bí mật. Model provider không thấy test set; evaluator không thấy model weights. Secure enclave trở thành vùng trung lập nơi phép tính diễn ra.
Double-blind evaluation có loại bỏ hoàn toàn benchmark contamination không?
Không. Google DeepMind dùng ngôn ngữ “help prevent benchmark contamination”, tức là giúp ngăn hoặc giảm một đường contamination quan trọng chứ không tuyên bố giải quyết tuyệt đối vấn đề.
Một model vẫn có thể đã học những ví dụ tương tự từ dữ liệu khác trước khi pilot diễn ra. Benchmark cũng có thể có vấn đề về độ đại diện, cách chấm điểm hoặc phạm vi quá hẹp. MLCommons nhấn mạnh rằng giữ bí mật đề thi thôi chưa đủ; một chương trình benchmark stewardship tốt vẫn cần thiết để duy trì tính toàn vẹn lâu dài.
AVERI cũng lưu ý thiết kế bảo mật của pilot xử lý nhiều nhưng không phải tất cả cách mà một nhà phát triển về lý thuyết có thể can thiệp vào đánh giá. Điều này quan trọng vì double-blind evaluation nên được hiểu là một lớp hạ tầng mới cho audit, không phải giấy chứng nhận rằng mọi kết quả benchmark từ nay đều hoàn hảo.
Vì sao cách đánh giá này đáng chú ý với AI Safety?
Khi model ngày càng mạnh, các bộ test nhạy cảm cũng trở nên khó chia sẻ hơn. Những benchmark về cybersecurity, biosecurity hoặc hành vi nguy hiểm có thể chứa prompt mà evaluator không muốn phát tán. Đồng thời, model frontier là tài sản có giá trị rất lớn nên nhà phát triển cũng không thể đơn giản gửi weights cho mọi tổ chức đánh giá.
Double-blind evaluation tạo ra một phương án trung gian: tổ chức độc lập có thể stress-test một model production trong môi trường được kiểm chứng mà không cần hai bên trao đổi trực tiếp tài sản mật. Đây là điều quan trọng nếu regulator, AI Safety Institute hoặc khách hàng doanh nghiệp muốn xác minh tuyên bố an toàn của model bằng dữ liệu riêng.
Nhu cầu này sẽ càng lớn khi AI chuyển từ trả lời văn bản sang hành động. Bot.io.vn đã đề cập xu hướng đó trong bài về Persistent AI Agent và Model Hardware Standard: một hệ thống càng tự chủ hoặc càng có khả năng tác động tới thế giới vật lý, yêu cầu đánh giá độc lập và đáng tin càng trở nên quan trọng.
Double-blind AI evaluation có lợi gì cho doanh nghiệp?
Doanh nghiệp không chỉ quan tâm model đạt bao nhiêu điểm trên benchmark công khai. Ngân hàng, bệnh viện, công ty công nghệ hoặc cơ quan chính phủ có thể muốn kiểm tra model trên dữ liệu và tình huống nội bộ nhưng không muốn gửi dữ liệu nhạy cảm cho nhà cung cấp model.
Về nguyên tắc, confidential computing và secure evaluation có thể tạo ra mô hình “kiểm tra mà không cần chia sẻ toàn bộ”. Nhà cung cấp giữ IP, khách hàng hoặc auditor giữ dữ liệu test, và chỉ kết quả đã thỏa thuận được đưa ra ngoài. Đây vẫn là hướng hạ tầng đang phát triển, nhưng nó mở ra một cách tiếp cận khác với việc chỉ tin vào benchmark do vendor tự công bố.
Những giới hạn của double-blind AI evaluation
• Không sửa được benchmark kém: nếu câu hỏi không đại diện cho rủi ro thực tế hoặc cách chấm không đáng tin, việc chạy chúng trong enclave cũng không làm benchmark tốt hơn.
• Không loại bỏ contamination lịch sử: secure evaluation bảo vệ test set trong lần đánh giá hiện tại, nhưng không thể xóa dữ liệu mà model đã vô tình thấy từ nguồn khác trước đó.
• Hạ tầng phức tạp: cần cơ chế attestation, quản lý khóa, kiểm soát code và quy trình thống nhất giữa nhiều tổ chức.
• Vẫn cần governance: ai chọn benchmark, ai quyết định output nào được công bố và ai audit hệ thống enclave đều là câu hỏi tổ chức chứ không chỉ kỹ thuật.
• Chưa phải chuẩn mặc định: pilot của DeepMind chứng minh một mô hình khả thi, nhưng secure enclave mới chỉ là một trong nhiều công nghệ có thể hỗ trợ deep, secure access cho AI auditing.
Câu hỏi thường gặp về benchmark contamination
Benchmark contamination có phải là model gian lận không?
Không nhất thiết. Contamination có thể xảy ra vô tình vì training corpus quá lớn, benchmark đã được đăng công khai hoặc quy trình đánh giá làm lộ prompt. Vấn đề nằm ở tính toàn vẹn của phép đo, không nhất thiết ở ý định của nhà phát triển.
Tại sao không dùng benchmark hoàn toàn công khai?
Benchmark công khai rất hữu ích cho minh bạch và nghiên cứu, nhưng khi model được huấn luyện trên dữ liệu web quy mô lớn, test set công khai dễ lọt vào training corpus hoặc trở thành mục tiêu tối ưu. Vì vậy nhiều benchmark dùng practice set công khai và official test set bí mật.
Google DeepMind đã thử nghiệm model nào?
Các báo cáo từ AVERI và OpenMined xác nhận pilot production sử dụng Gemini 2.5 Flash-Lite. Google DeepMind mô tả chung đây là một Gemini Flash Lite model.
Ai tham gia pilot double-blind evaluation?
Các tổ chức được công bố gồm Google DeepMind, OpenMined, AVERI, MLCommons và Singapore AI Safety Institute. OpenMined cung cấp PySyft; MLCommons và Singapore AISI cung cấp các prompt đánh giá chưa phát hành; AVERI thực hiện một trong các pilot đánh giá.
Kết quả benchmark của Gemini 2.5 Flash-Lite có được công bố không?
Không công khai đầy đủ. AVERI cho biết báo cáo chi tiết được gửi bí mật cho Google DeepMind. Việc không phát hành prompt và output cụ thể giúp bảo vệ tính toàn vẹn của benchmark cho các lần đánh giá sau.
Double-blind evaluation có thể dùng cho model của hãng khác không?
Về nguyên tắc có. Phương pháp dựa trên confidential computing, enclave và cơ chế orchestration chứ không phụ thuộc riêng vào Gemini. Tuy nhiên, mỗi nhà cung cấp phải hỗ trợ cách đóng gói model, attestation và quy trình bảo mật tương thích.
Điều gì đáng theo dõi tiếp theo?
Pilot của Google DeepMind đáng chú ý không phải vì nó tạo ra một benchmark mới, mà vì nó thay đổi cách các bên có thể tin vào quá trình đánh giá. Nếu evaluator không cần giao đề thi cho model provider và model provider không cần giao weights cho evaluator, external auditing có thể trở nên thực tế hơn với các model frontier.
Ba câu hỏi cần theo dõi là liệu secure evaluation có được nhiều AI lab áp dụng, liệu các AI Safety Institute có biến deep secure access thành yêu cầu audit thường xuyên, và liệu chuẩn chung nào sẽ xuất hiện để các enclave của nhiều nhà cung cấp có thể được kiểm chứng độc lập. Nếu những lớp hạ tầng này trưởng thành, “model đạt bao nhiêu điểm” sẽ không còn là câu hỏi duy nhất; ngành AI còn phải chứng minh điểm số đó được tạo ra bằng một phép đo đáng tin đến mức nào.